

Linux avanzado | unfantasmaenelsistema.com
Imagina que puedes ejecutar código dentro del kernel de Linux sin modificar el kernel, sin escribir un módulo, y con la garantía de que tu código no podrá bloquear ni corromper el sistema. Imagina que ese código puede observar cada syscall, cada paquete de red, cada acceso a memoria, con overhead prácticamente nulo. Eso es eBPF.
Cloudflare la usa para bloquear ataques DDoS a velocidades de decenas de millones de paquetes por segundo. Meta la usa para observar su infraestructura de cientos de miles de servidores. El proyecto Cilium, que usa Kubernetes en Google Cloud, AWS y Azure, está construido enteramente sobre eBPF.
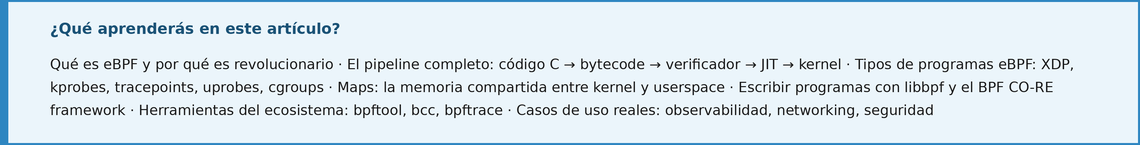
1. El pipeline de un programa eBPF

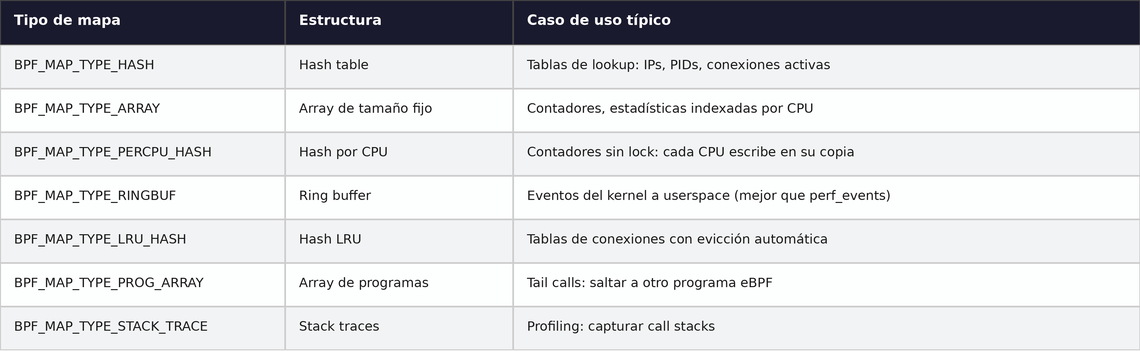
2. Mapas: la memoria persistente de eBPF
Los programas eBPF son stateless por diseño. La comunicación de estado entre el kernel y userspace se hace a través de BPF maps: estructuras de datos en el kernel accesibles desde ambos lados mediante file descriptors.
3. Tipos de programas eBPF

3.1 XDP: procesamiento de paquetes antes que el kernel

4. Escribir programas eBPF con libbpf y CO-RE
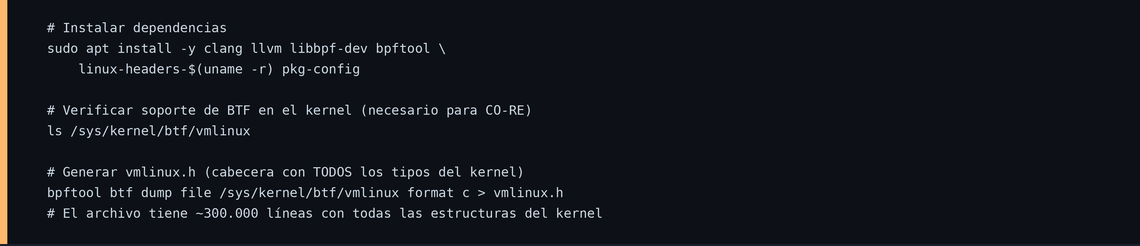
4.1 Primer programa: contar syscalls por PID
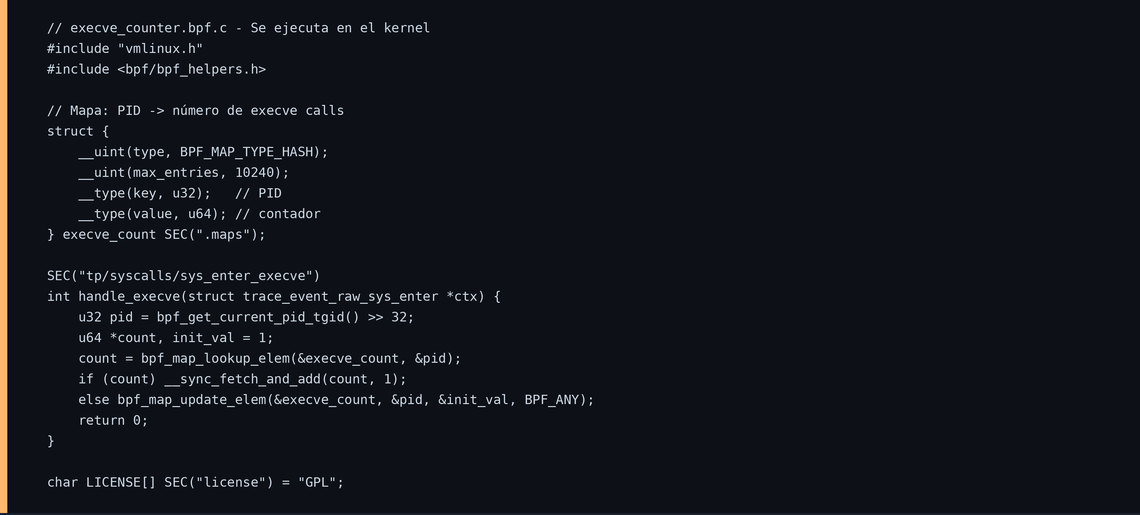
5. El ecosistema de herramientas
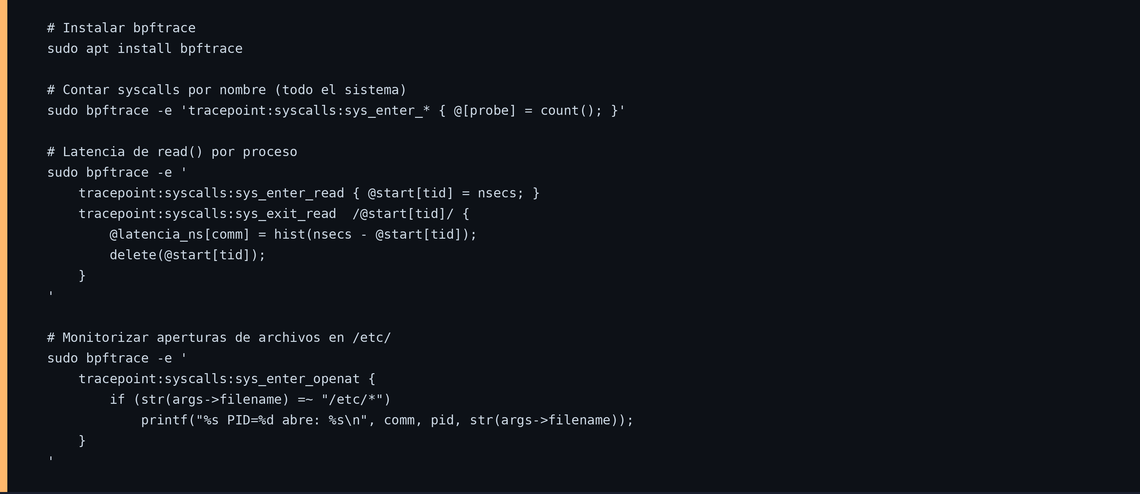
5.1 bpftrace: scripting de alto nivel para tracing
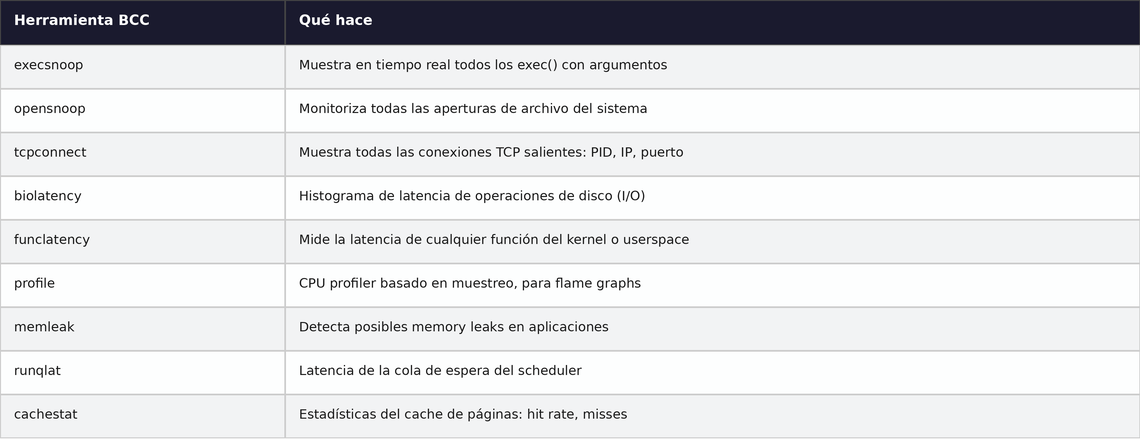
5.2 BCC: herramientas listas para usar
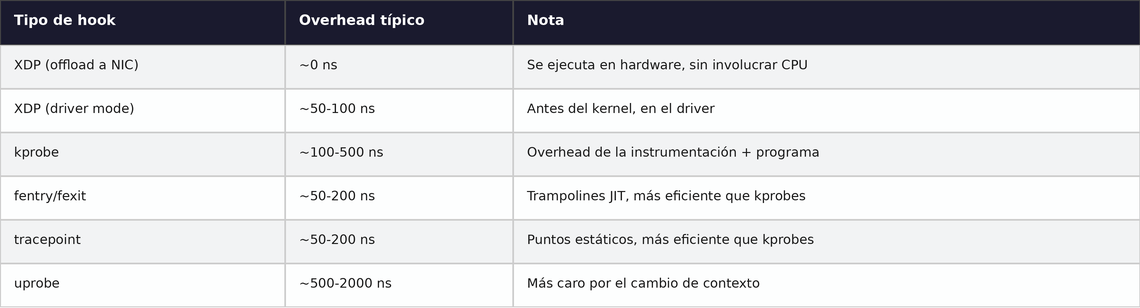
6. Performance y limitaciones
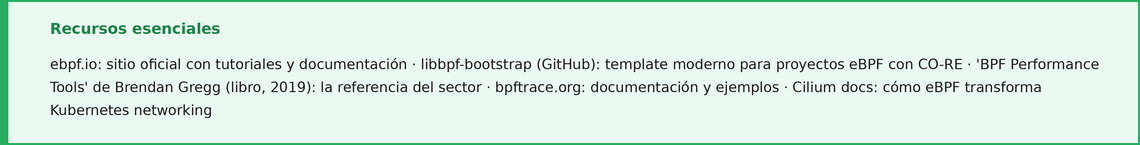
Conclusión
eBPF representa un cambio de paradigma en cómo interactuamos con el kernel de Linux. Durante décadas, extender el kernel significaba escribir módulos en C, arriesgarse a desestabilizar el sistema, y reiniciar servidores. eBPF cambia eso completamente: programas verificados formalmente, cargados en caliente, con overhead de nanosegundos, y que desaparecen sin dejar rastro cuando ya no se necesitan.
unfantasmaenelsistema.com | Seguridad, sistemas y todo lo que no debería funcionar (pero funciona)